💎 未登录 · 访问全部资源需会员 👤 登录 / 注册
🎯 目标检测专题 · arXiv 近三年文献精读

目标检测:从原理到发论文

检测器怎么搭、这几年论文改了什么、哪些方向还值得做—— 一页讲清检测器的三段式架构,30 篇 arXiv 论文逐篇拆解核心思想与创新点, 配 9 张自绘原理架构图,最后落到可复现的实验路线与可直接开题的选题清单。

30篇 arXiv 论文精读
9张自绘原理架构图
5条研究主线
21篇落在近三年窗口
6个可直接开题的选题
📐 先看检测器怎么搭 📚 直接进文献精读 🎓 看科研选题建议

任何检测器,都是三段式

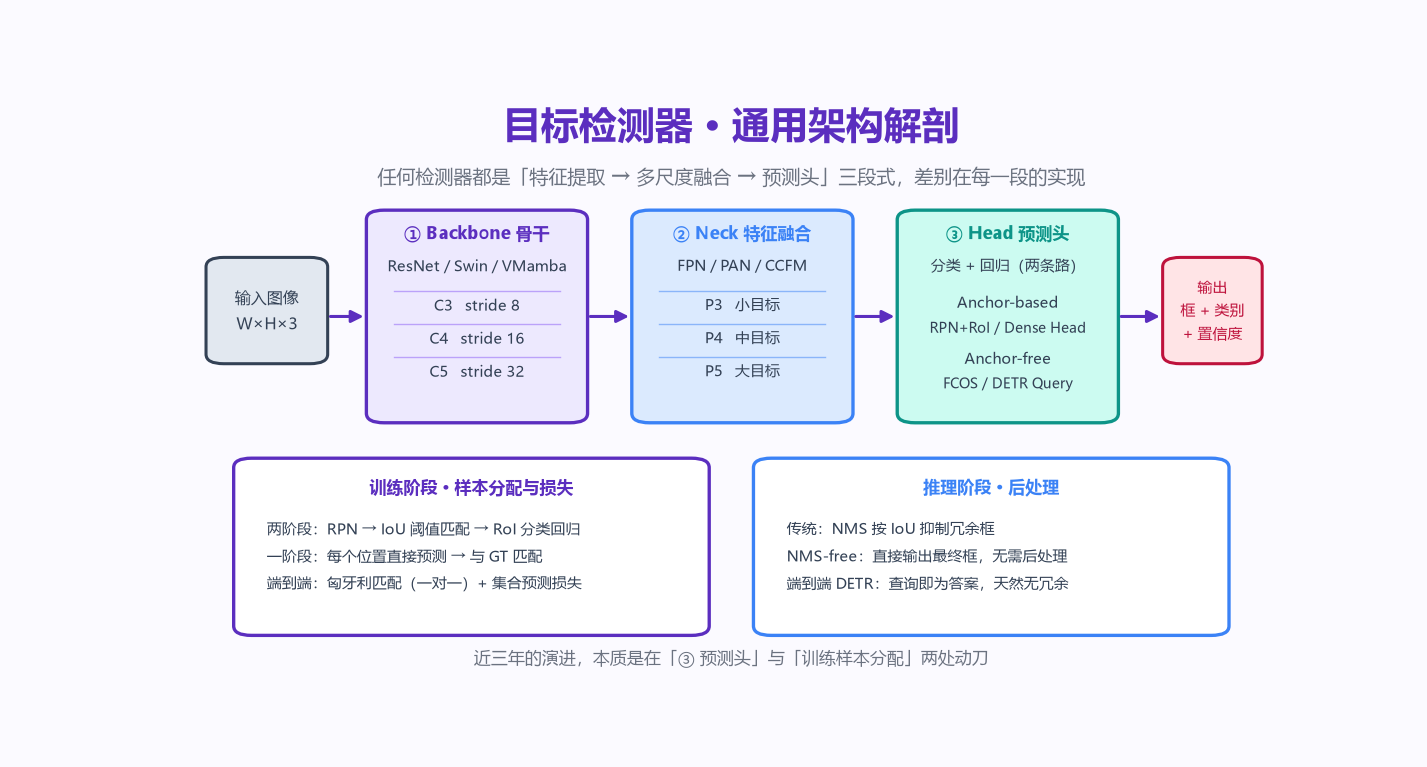
特征提取 → 多尺度融合 → 预测头。近三年所有新工作,改的都是这两三段里的某一处。

目标检测器通用架构解剖图:输入图像经过 Backbone 骨干提取 C3/C4/C5 多尺度特征,经 Neck 特征融合得到 P3/P4/P5,最后由 Head 预测头输出框、类别与置信度;下方对比训练阶段的样本分配与推理阶段的后处理差异
图 8 · 目标检测器通用架构解剖(点击放大)

为什么值得先看这张图

  • Backbone:决定特征质量上限,R50 → Swin → VMamba / TransNeXt / DINOv3
  • Neck:决定多尺度信息怎么融合,FPN / PAN / CCFM 三代演进
  • Head:决定输出形式,anchor-based 与 anchor-free 两条分水岭
  • 训练侧与推理侧要目标一致——这是 YOLOv10 与 DETR 共同的底层主张

读论文时先把这张图摆出来,问自己三个问题: 这篇论文动的是哪一段?是训练侧还是推理侧? 几乎所有检测论文都能被塞进这个框架里。

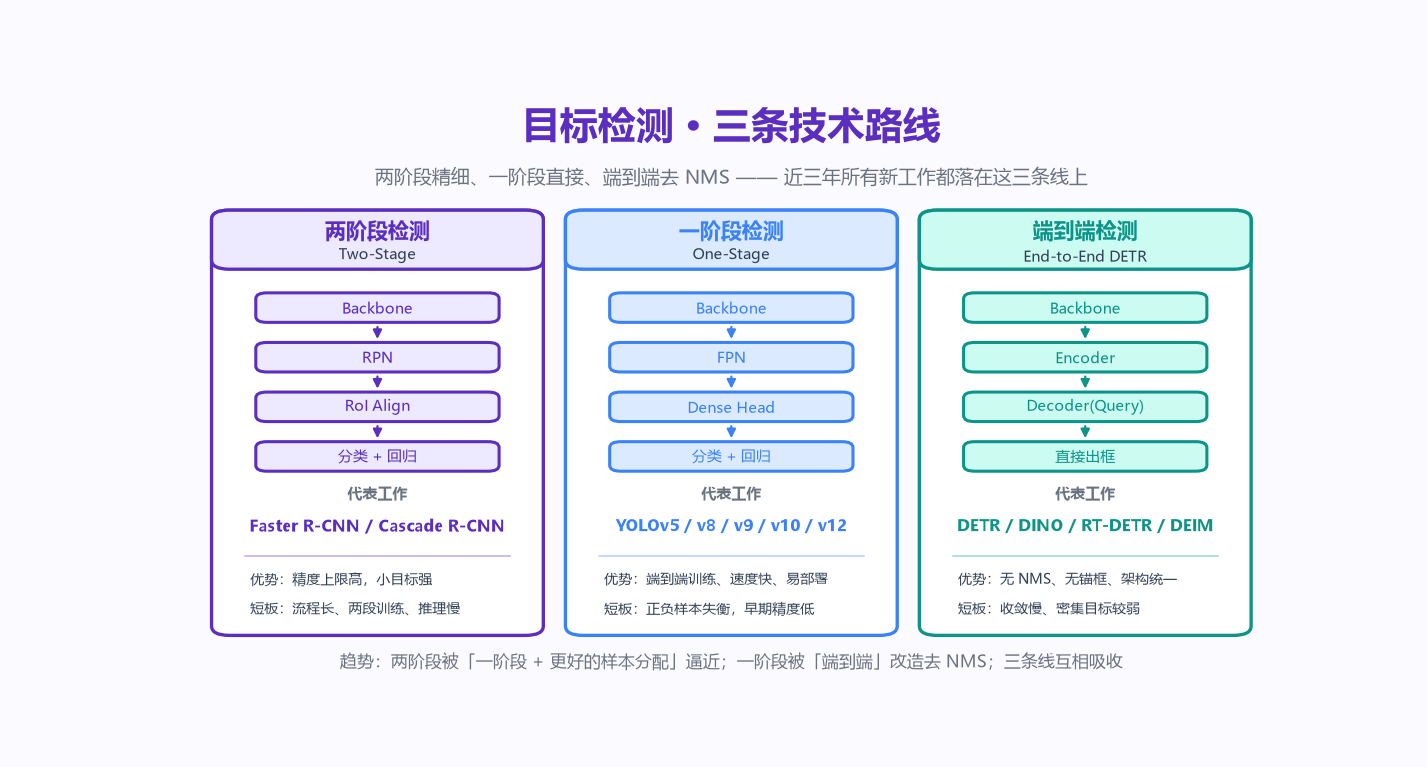
目标检测三条技术路线对比图:两阶段检测(Backbone-RPN-RoI Align-分类回归,代表 Faster R-CNN)、一阶段检测(Backbone-FPN-Dense Head,代表 YOLOv5 到 v12)、端到端 DETR 检测(Backbone-Encoder-Decoder 直接出框,代表 DETR/DINO/RT-DETR/DEIM),并对比各自优势与短板
图 9 · 三条技术路线对比(点击放大)

三条路线,正在互相吸收

  • 两阶段:精度上限高、小目标强,但流程长、推理慢
  • 一阶段:端到端训练、速度快、易部署,早期正负样本失衡
  • 端到端 DETR:无 NMS、无锚框、架构统一,但早期收敛慢
  • 趋势:两阶段被「一阶段 + 更好的样本分配」逼近,一阶段被「端到端」改造

写综述时,这张表是最好用的骨架:按路线分类,而不是按年份罗列, 读者才能一眼看出每个方向还缺什么。

DETR 端到端检测:训练与推理原理

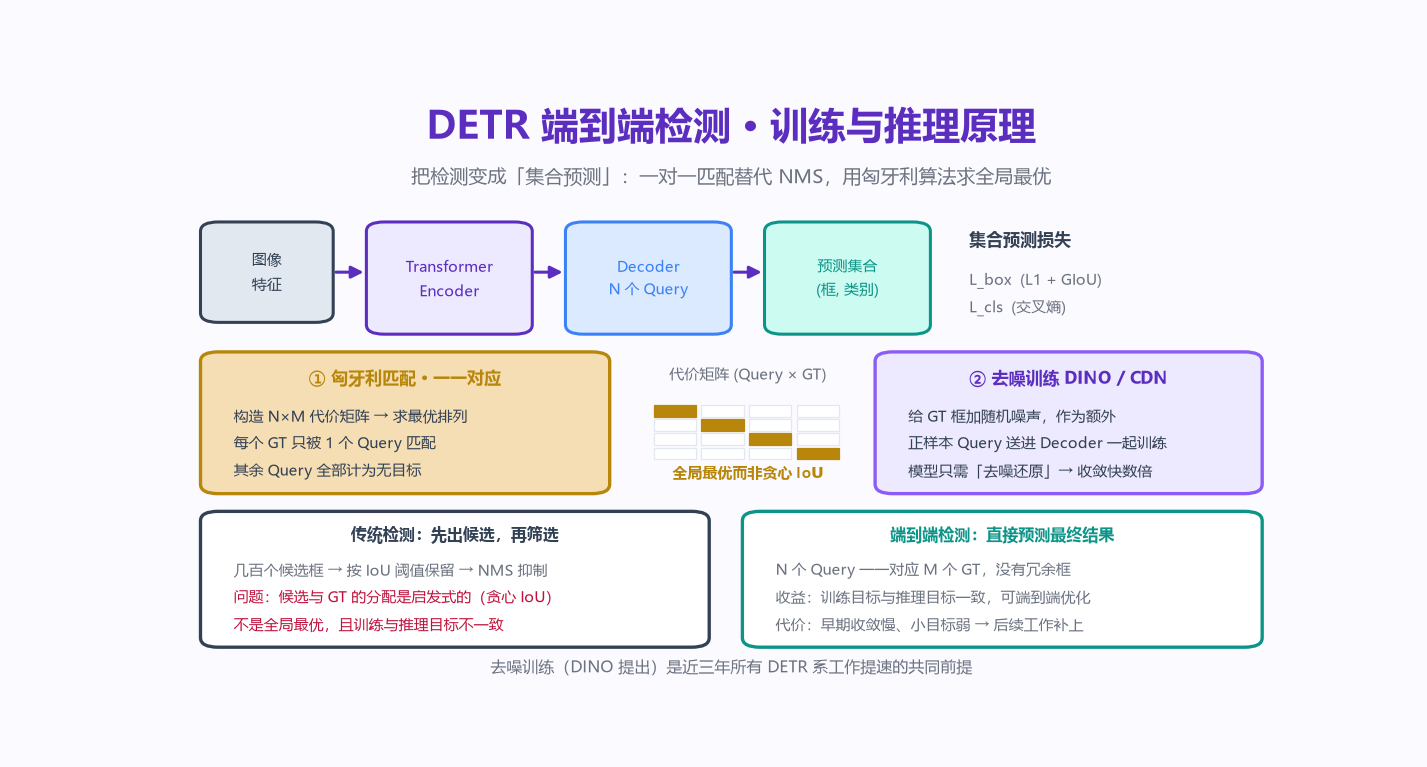
把检测变成「集合预测」:一对一匹配替代 NMS,用匈牙利算法求全局最优。 这张图是后面所有 DETR 系论文的地基。

DETR 端到端检测训练与推理原理图:图像特征经 Transformer Encoder、Decoder 的 N 个 Query 预测出框与类别的集合;下方展示匈牙利匹配的一一对应与代价矩阵、去噪训练 CDN,以及传统检测与端到端检测的对比
图 10 · DETR 端到端训练原理(点击放大)

① 匈牙利匹配:把「分配」变成优化问题

构造 N×M 代价矩阵(分类损失 + L1 + GIoU),用匈牙利算法求全局最优排列,而不是传统检测那样按 IoU 贪心阈值分配候选框。每个 GT 只被 1 个 Query 匹配,其余 Query 全部记为无目标——这就是「无冗余框」的来源。

② 去噪训练 CDN:所有 DETR 系提速的共同前提

给 GT 框加随机噪声,把这些「带噪框」当成额外正样本 Query 一起送进 Decoder。模型只要学会「去噪还原」,收敛速度就能提升数倍——DETR 原本需要 500 epoch 才能训好,加了去噪之后 12 epoch 就够。

③ 两条改进轴:匹配方式 与 回归形式

DEIM 改的是匹配(密集一对一 → 更快收敛),D-FINE 改的是回归(L1 单点 → 细粒度分布细化 → 更准定位)。两件事在数学上彼此正交,因此可以叠加——这正是写文章时最顺的一条叙事线。

近三年 arXiv 文献精读

30 篇论文,逐篇给出核心思想、创新点、代表性指标与「写文章时该怎么引用」。 全部论文标题、作者、发布日期与 arXiv 编号均取自 arXiv 官方 API,可直接核对。

📌 关于「近三年」这个窗口的说明

严格意义上的近三年窗口是 2023-10 → 2026-10,落在窗口内的共 21 篇,标记为 近三年窗口内。 另外 9 篇 是这条技术路线上不可绕过的奠基前置工作 (DINO、RT-DETR、Grounding DINO、OWLv2、Florence-2 等,最早可追溯到 2022 年), 标记为 奠基前置。
把它们放进来是有意的:近三年的每一篇工作,都在引用和修改这些前置工作。 不引用前置工作,综述就断了链条——这也是审稿人最容易质疑的地方。

01

端到端 DETR 系

集合预测 · 匹配机制 · 回归形式
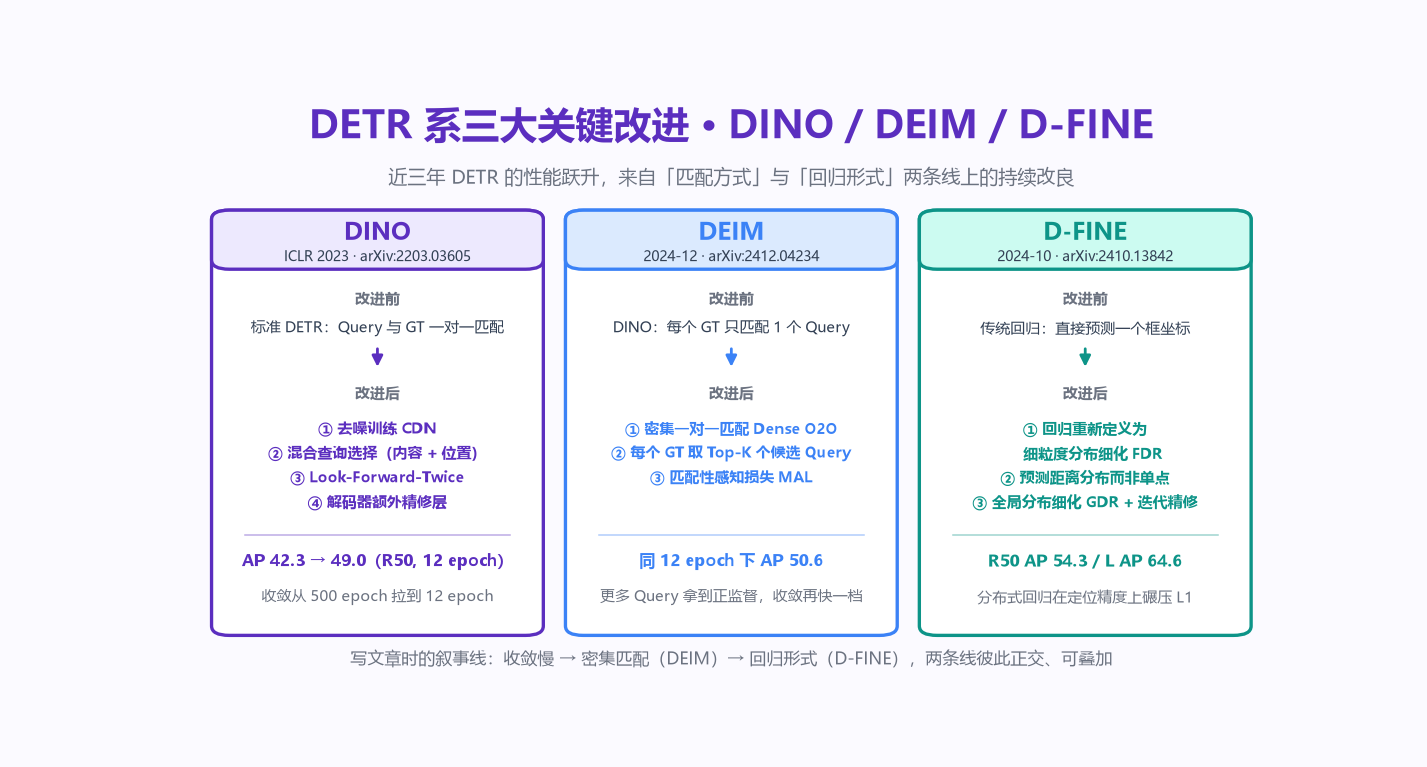
端到端路线把检测从「先出候选再筛选」改写成「直接预测一个集合」。这条线的三年进展几乎全部集中在两处:预测与 GT 怎么配对(匈牙利匹配 → 密集一对一 → 图协作),以及框怎么回归(L1 单点 → 细粒度分布细化)。这两件事彼此正交,因此可以叠加——这正是写文章时最好讲的叙事结构。
11:DETR 系三大关键改进:DINO 改收敛、DEIM 改匹配、D-FINE 改回归
图 11 · DETR 系三大关键改进:DINO 改收敛、DEIM 改匹配、D-FINE 改回归
ICLR 2023 端到端 DETR 系 奠基前置

DINO: DETR with Improved DeNoising Anchor Boxes for End-to-End Object Detection

DINO:带改进去噪锚框的端到端目标检测 DETR
arXiv:2203.03605 · 2022-03-07 · Hao Zhang、Feng Li、Shilong Liu 等 8 人
核心思想把 DETR 的集合预测与去噪训练结合——给 GT 框加噪构造额外的正样本 Query,让 Decoder 同时学习「去噪还原」,把收敛所需的 500 epoch 压到 12 epoch。
创新点
  • 引入对比去噪 CDN:给 GT 框加随机噪声,生成额外正样本 Query
  • 混合查询选择:把编码器的内容特征与位置锚点拼接起来选初始 Query
  • Look-Forward-Twice:在分支之间传递梯度,稳定深层监督
  • 解码器额外精修层:逐层提升框的定位精度
📊 COCO AP 42.3 → 49.0(ResNet-50,12 epoch)
✍️ 凡是要写「DETR 收敛慢」或「去噪训练」,这一篇是必引的前置工作,也是 DEIM / D-FINE 等后续改进的共同前提。
arXiv:2203.03605 原文 ↗
ICCV 2023 (Oral) 端到端 DETR 系 奠基前置

DiffusionDet: Diffusion Model for Object Detection

DiffusionDet:用扩散模型做目标检测
arXiv:2211.09788 · 2022-11-17 · Shoufa Chen、Peize Sun、Yibing Song 等 4 人
核心思想把检测重述为「从带噪框集合到真实框集合」的扩散去噪过程——以随机初始化的框作为扩散起点,用迭代去噪逐步精修出最终检测结果,天然不需要 NMS。
创新点
  • 首次把扩散模型的加噪 / 去噪范式引入目标检测
  • 随机框作为扩散起点,等价于隐式建模整个检测结果的分布
  • 去噪过程中逐级精修框坐标与类别,天然免 NMS
📊 COCO AP 46.4(L 级骨干,RefineNet)
✍️ 讲「集合预测的另一种范式」或「扩散模型做感知任务」时引用;2024 年之后扩散式检测大量跟进,是一条活的支线。
arXiv:2211.09788 原文 ↗
ICCV 2023 端到端 DETR 系 奠基前置

DETRs with Collaborative Hybrid Assignments Training

协同混合分配训练的 DETR(Co-DETR)
arXiv:2211.12860 · 2022-11-22 · Zhuofan Zong、Guanglu Song、Yu Liu
核心思想指出 DETR 的「一对一匹配」导致正样本过于稀疏,改为在多个辅助检测头上做混合分配(一对一 + 一对多)协同训练,最后只保留主头的输出做推理。
创新点
  • 协同混合分配训练:多个辅助头采用不同的正负样本分配策略
  • 正样本集合在辅助头之间共享,互相「借」监督信号
  • 推理时只保留一对一主头,完整保留 NMS-free 特性
📊 COCO AP 51.0 级别,显著加速收敛
✍️ 讨论「正样本稀疏」「一对一匹配的信息瓶颈」时引用;与 DEIM 的 Dense O2O 是同期但独立的两种解法。
arXiv:2211.12860 原文 ↗
ICLR 2025 端到端 DETR 系 近三年窗口内

D-FINE: Redefine Regression Task in DETRs as Fine-grained Distribution Refinement

D-FINE:把 DETR 的回归任务重新定义为细粒度分布细化
arXiv:2410.13842 · 2024-10-17 · Yansong Peng、Hebei Li、Peixi Wu 等 6 人
核心思想认为 L1 回归是 DETR 定位精度的瓶颈,于是把回归从「预测一个坐标」改成「预测一个以真值为中心的离散分布」,再对分布做细化,把定位精度整体抬高一个档次。
创新点
  • FDR 细粒度分布细化:预测离散分布而非单点坐标
  • GDR 全局分布细化:借高层特征迭代优化整层分布
  • 分布式回归天然编码了定位不确定性
  • 可直接叠加到 DINO / DEIM 等已有框架上
📊 COCO ResNet-50 AP 54.3;12 epoch 训练即超越此前最好结果
✍️ 讨论「回归形式」「定位精度瓶颈」时引用;与 DEIM 的匹配改进构成两条正交的技术线。
arXiv:2410.13842 原文 ↗
CVPR 2025 端到端 DETR 系 近三年窗口内

DEIM: DETR with Improved Matching for Fast Convergence

DEIM:用改进的匹配实现快速收敛的 DETR
arXiv:2412.04234 · 2024-12-05 · Shihua Huang、Zhichao Lu、Xiaodong Cun 等 6 人
核心思想指出密集一对一匹配能提供更丰富的正样本监督,从而在同样的 12 epoch 内比 DINO 收敛得更快;同时用匹配性感知损失抑制低质量匹配对训练的干扰。
创新点
  • Dense O2O 密集一对一匹配:每个 GT 取 Top-K 个高重叠 Query
  • 匹配性感知损失 MAL:按匹配质量给分类 / 回归损失加权
  • 保持一对一推理特性,不引入额外推理延迟
  • 可直接叠加到 DINO / D-FINE 上形成复合收益
📊 COCO AP 50.6(ResNet-50,12 epoch),对比 DINO 的 49.0
✍️ 讨论「收敛速度」「正样本数量」时引用;是 DINO → DEIM → D-FINE 这条叙事线里的关键一环。
arXiv:2412.04234 原文 ↗
arXiv 2026-03 端到端 DETR 系 近三年窗口内

OV-DEIM: Real-time DETR-Style Open-Vocabulary Object Detection with GridSynthetic Augmentation

OV-DEIM:带网格合成增广的实时 DETR 式开放词汇目标检测
arXiv:2603.07022 · 2026-03-07 · Leilei Wang、Longfei Liu、Xi Shen 等 7 人
核心思想现有实时开放词汇检测几乎都建在 YOLO 系模型上,而 DETR 式方案在延迟、轻量化与整体性能上都落后;OV-DEIM 在最新的 DEIMv2 框架上构建端到端 DETR 式开放词汇检测器,并整合视觉语言建模做高效推理。
创新点
  • 基于 DEIMv2 的端到端 DETR 式开放词汇检测器,兼顾延迟与轻量化
  • 查询补充策略:在不牺牲推理速度的前提下提升 Fixed AP
  • GridSynthetic 网格合成增广:一次前向内组合多个训练样本
  • 用更丰富的共现关系与空间布局缓解噪声定位对分类损失的污染
📊 实时开放词汇基准上取得领先的整体性能与 Fixed AP(详见原文)
✍️ 写「端到端检测器如何做开放词汇」或「增广策略影响分类损失」时引用;是 DEIM 系列的最新延伸。
arXiv:2603.07022 原文 ↗
arXiv 2026-08 端到端 DETR 系 近三年窗口内

Match One, Learn with Graph: One-to-Graph Query Collaboration with Backward Sharing for Object Detection

Match One, Learn with Graph:面向目标检测的一对一图查询协作与反向共享
arXiv:2609.26092 · 2026-08-06 · Wenxiao Fan、Jingling Fu、Luohang Liu 等 11 人
核心思想指出 O2O 匹配下,一个目标的最佳分类、中心、尺度与重叠证据往往分散在多个 query 上,只有被匹配的「属主」拿到正监督——作者称之为「query 知识碎片化」;BS-O2G 用稀疏的预测感知图组织 query 协作,同时完整保留原 O2O 匹配器、正标签与目标函数。
创新点
  • 提出并命名「query 知识碎片化」问题
  • O2G 图上校准:在前向传播相对消息,聚合各 query 上的互补证据
  • Backward Sharing:复用转置且去梯度的邻接矩阵,在持久 query 基向量之间路由梯度
  • 不改动匹配器与推理结构,可即插即用地挂在不同 DETR 上
📊 在多种 DETR、多种骨干、COCO 与 CrowdHuman 上一致提升,且收敛更快
✍️ 讨论「一对一匹配的信息瓶颈」或「正样本监督不足」时引用;是 DEIM 之后查询侧改进的新思路。
arXiv:2609.26092 原文 ↗
arXiv 2026-10 端到端 DETR 系 近三年窗口内

Dynamic Query as Budgeting for Tiny Object Detection

Dynamic Query as Budgeting:把小目标检测的动态查询重述为「预算分配」
arXiv:2610.33430 · 2026-10-24 · Yi Zhang、Di Xiong、Ge Gao 等 7 人
核心思想指出 DETR 系小目标检测器的动态查询机制把两件事纠缠在一起——解多少个 query、以及选哪些 query;实验证明动态查询的主要作用是「预算分配」(按目标密度分配解码容量),而非精细的查询选择。
创新点
  • 把动态查询重述为单调且保守的预算分配原则
  • 轻量、非学习的 budgeter:由编码器置信度估计输入相关的 query 预算 K(x)
  • 保留标准 Top-K(x) 查询初始化,不引入额外学习模块或启发式过滤
  • 直接消掉了预算器里的选择误差来源
📊 800×800 分辨率下 BUTR-L 在 AI-TOD-v2 达 35.7 AP / 47.8 FPS,在 VisDrone 达 29.8 AP / 42.1 FPS(T4)
✍️ 讨论「动态查询到底在做什么」或「小目标的 query 预算如何定」时引用;对小目标方向尤其有用。
arXiv:2610.33430 原文 ↗
02

实时检测

把速度与精度同时往前推一格
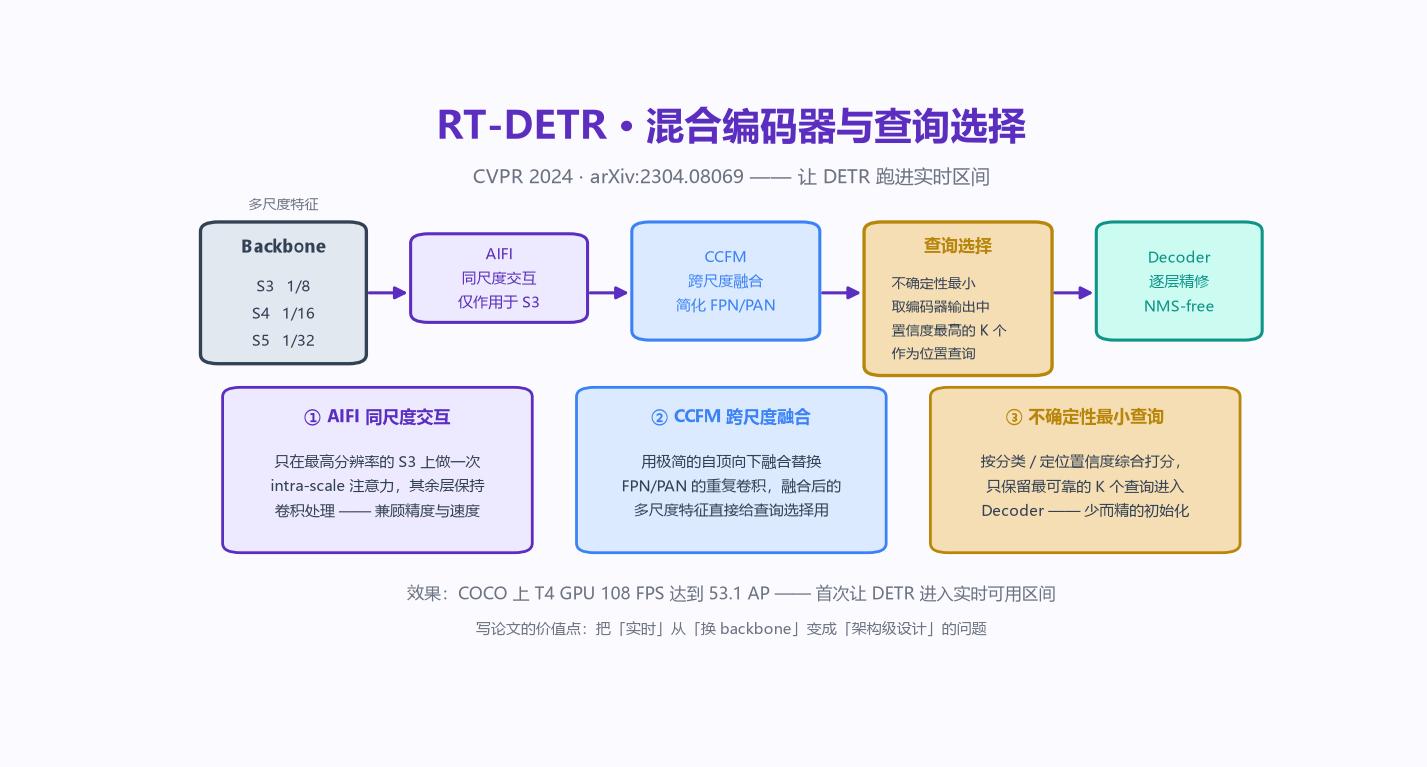
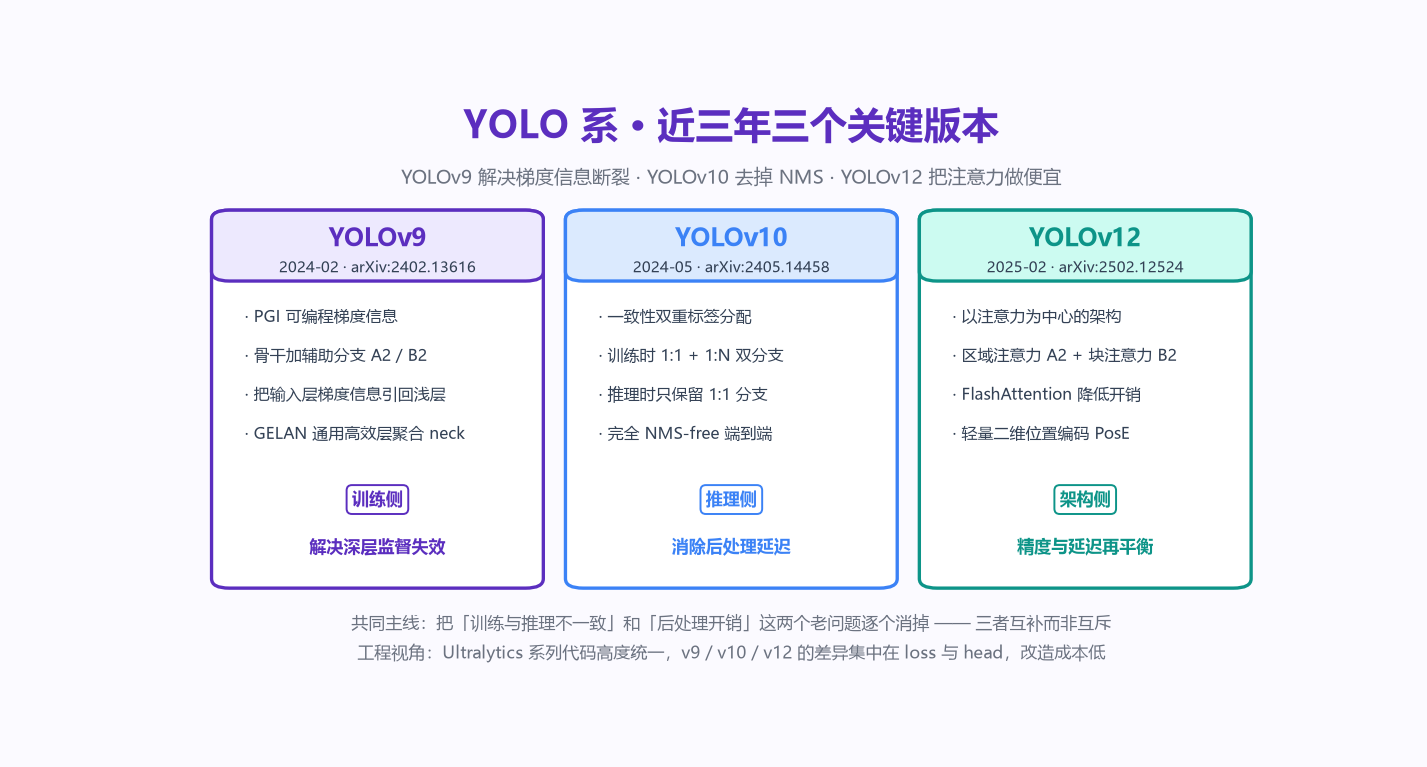
实时线的核心矛盾是「训练与推理不一致」和「后处理开销」这两个历史包袱。YOLOv9 用可编程梯度信息解决深层监督失效,YOLOv10 用一致性双重标签分配彻底去掉 NMS,YOLOv12 把注意力做便宜;RT-DETR 则从 DETR 一侧证明端到端也能实时。三条路径互补而非互斥,是可以并排写进一张对比表的。
12:RT-DETR 混合编码器:把 CNN 多尺度特征、AIFI 与 Transformer Encoder 融进同一条实时推理链路
图 12 · RT-DETR 混合编码器:把 CNN 多尺度特征、AIFI 与 Transformer Encoder 融进同一条实时推理链路
13:YOLO 系近三年三个关键版本:v9 改训练信号、v10 去 NMS、v12 把注意力做便宜
图 13 · YOLO 系近三年三个关键版本:v9 改训练信号、v10 去 NMS、v12 把注意力做便宜
CVPR 2024 实时检测 奠基前置

DETRs Beat YOLOs on Real-time Object Detection

DETRs 在实时目标检测上击败 YOLO(RT-DETR)
arXiv:2304.08069 · 2023-04-17 · Yian Zhao、Wenyu Lv、Shangliang Xu 等 8 人
核心思想认为 DETR 慢的根源在编码器冗余计算与查询初始化质量,于是用高效混合编码器压缩计算量,并用「不确定性最小」的查询选择取代传统查询初始化。
创新点
  • AIFI:只在最高分辨率的 S3 上做一次同尺度注意力,其余层保持卷积
  • CCFM:以极简的自顶向下融合替代 FPN/PAN 的重复卷积
  • 不确定性最小查询选择:按分类 / 定位置信度筛出最可靠的 K 个查询
  • 推理全程 NMS-free,可直接导出为部署模型
📊 COCO 上 T4 GPU 108 FPS 达到 53.1 AP;TensorRT FP16 达 217 FPS
✍️ 讨论「端到端检测器如何实时化」或「混合编码器」时引用;是把 DETR 推进到工程可用区间的代表作。
arXiv:2304.08069 原文 ↗
ECCV 2024 实时检测 近三年窗口内

YOLOv9: Learning What You Want to Learn Using Programmable Gradient Information

YOLOv9:用可编程梯度信息学习你想学的东西
arXiv:2402.13616 · 2024-02-21 · Chien-Yao Wang、I-Hau Yeh、Hong-Yuan Mark Liao
核心思想发现深层网络中梯度信息在反向传播中会因「深度监督不足」和「梯度融合」而丢失,于是设计可编程梯度信息(PGI)生成器,在骨干与 neck 之间插入辅助分支把梯度信息回传到浅层。
创新点
  • PGI 可编程梯度信息生成器
  • 骨干加辅助分支 A2 / B2,把输入层梯度信息引回浅层
  • GELAN 通用高效层聚合 neck,提升特征融合效率
  • 无需大规模数据集预训练即可稳定训练
📊 COCO AP 47.0 / 47.1(L 级),超过同规模 YOLOv8 且参数更少
✍️ 讨论「训练信号与推理不一致」「梯度信息丢失」时引用;是 YOLO 近年最重要的机理型改进。
arXiv:2402.13616 原文 ↗
NeurIPS 2024 实时检测 近三年窗口内

YOLOv10: Real-Time End-to-End Object Detection

YOLOv10:实时端到端目标检测
arXiv:2405.14458 · 2024-05-23 · Ao Wang、Hui Chen、Lihao Liu 等 7 人
核心思想指出一阶段检测器推理时仍需 NMS,这是训练 / 推理不一致的根源,于是引入一致性双重标签分配——训练时同时跑 1:1(无 NMS)与 1:N(NMS)两条分支,推理时只用 1:1 分支。
创新点
  • 一致性双重标签分配:训练期 1:1 与 1:N 双分支并行监督
  • 推理期只保留 1:1 分支,彻底去掉 NMS
  • 引入面向小目标的全标签分配正则项
  • 无需预训练权重或定制算子,部署成本低
📊 COCO AP 46.3(L 级);相对 YOLOv9 速度提升约 1.8×、模型体积降至约 1/2.8
✍️ 讨论「NMS-free 的一阶段检测」时引用;与 RT-DETR 的 NMS-free 路线可以直接对照着写。
arXiv:2405.14458 原文 ↗
arXiv 2025 实时检测 近三年窗口内

YOLOv12: Attention-Centric Real-Time Object Detectors

YOLOv12:以注意力为中心的实时目标检测器
arXiv:2502.12524 · 2025-02-18 · Yunjie Tian、Qixiang Ye、David Doermann
核心思想认为实时检测器过去只卷积不用注意力,是出于「注意力太贵」的误解;于是把注意力高效化(区域注意力 + 块注意力 + FlashAttention),做成以注意力为中心的架构,速度不变而精度上台阶。
创新点
  • 区域注意力 A2:在区域之间共享上下文,注意力只在区域内计算
  • 块注意力 B2:块内高维注意力,块间用卷积承接
  • 轻量二维位置编码 PosE
  • FlashAttention 降低注意力开销
📊 COCO AP 40.6(L 级),延迟与 YOLOv10 / v11 同级而精度更高
✍️ 讨论「注意力实时化」「卷积与注意力的权衡」时引用;是 YOLO 系列最新的架构方向。
arXiv:2502.12524 原文 ↗
arXiv 2026-10 实时检测 近三年窗口内

Order Matters: Competition-Guided Query Ordering for RNN-Based Object Detection

Order Matters:面向 RNN 式目标检测的竞争引导查询排序
arXiv:2610.05191 · 2026-10-04 · Shengjian Wu、Li Sun、Yu Shangguan 等 4 人
核心思想没有显式去重时,多个 query 仍会对同一目标给出高度相似的假设,导致训练不稳、预测不果断;借鉴 NMS 的顺序性,DETRNN 把无序的 object query 变成「竞争感知的序列」,再用 RNN 沿这个序列循环精修。
创新点
  • 基于置信度与相似度的显式排序,把无序 query 组织成有序序列
  • RNN 沿排序做竞争感知的循环精修,在 decoder 内部建模 query 间的竞争
  • 抑制冗余预测、稳定优化过程,同时保持与 NMS-free 推理的兼容
📊 在多个 DETR 系检测器上取得一致提升,且效率基本不变
✍️ 讨论「NMS-free 仍会出重复框」或「查询冗余与排序」时引用;把 NMS 的先验巧妙搬进 decoder 内部。
arXiv:2610.05191 原文 ↗
arXiv 2026-10 实时检测 近三年窗口内

RT-DETR-World: Transferring Rich LLM Semantics to Real-Time Open-Vocabulary Detection

RT-DETR-World:把大语言模型的丰富语义迁移到实时开放词汇检测
arXiv:2610.09502 · 2026-10-07 · Yupeng Zhang、Ziyi Zhao、Juntao Cheng 等 7 人
核心思想指出紧凑型实时检测器难以吸收丰富的实例语义,于是构建 GroundingCapv2 三级监督(类别名 / 物体描述 / 图像描述),把属性、动作、状态与上下文关系在训练期灌进检测器,推理期仍保持轻量的 query—文本匹配。
创新点
  • GroundingCapv2 数据集:类别名 / 实例级描述 / 图像级描述三级语义监督
  • 双路描述对齐 DDA:部署一致的 MiniLM 路径与非语言模型路径共同对齐
  • 描述只用于训练期,推理期保持紧凑的 query—文本匹配,不增加推理成本
📊 在实时开放词汇基准上以紧凑模型取得领先精度(详见原文表格)
✍️ 讨论「实时检测器如何吸收 LLM 语义」或「训练期监督注入」时引用;是 2026 年实时开放词汇方向的代表作。
arXiv:2610.09502 原文 ↗
03

开放词汇检测

从闭集 80 类到任意文本类别
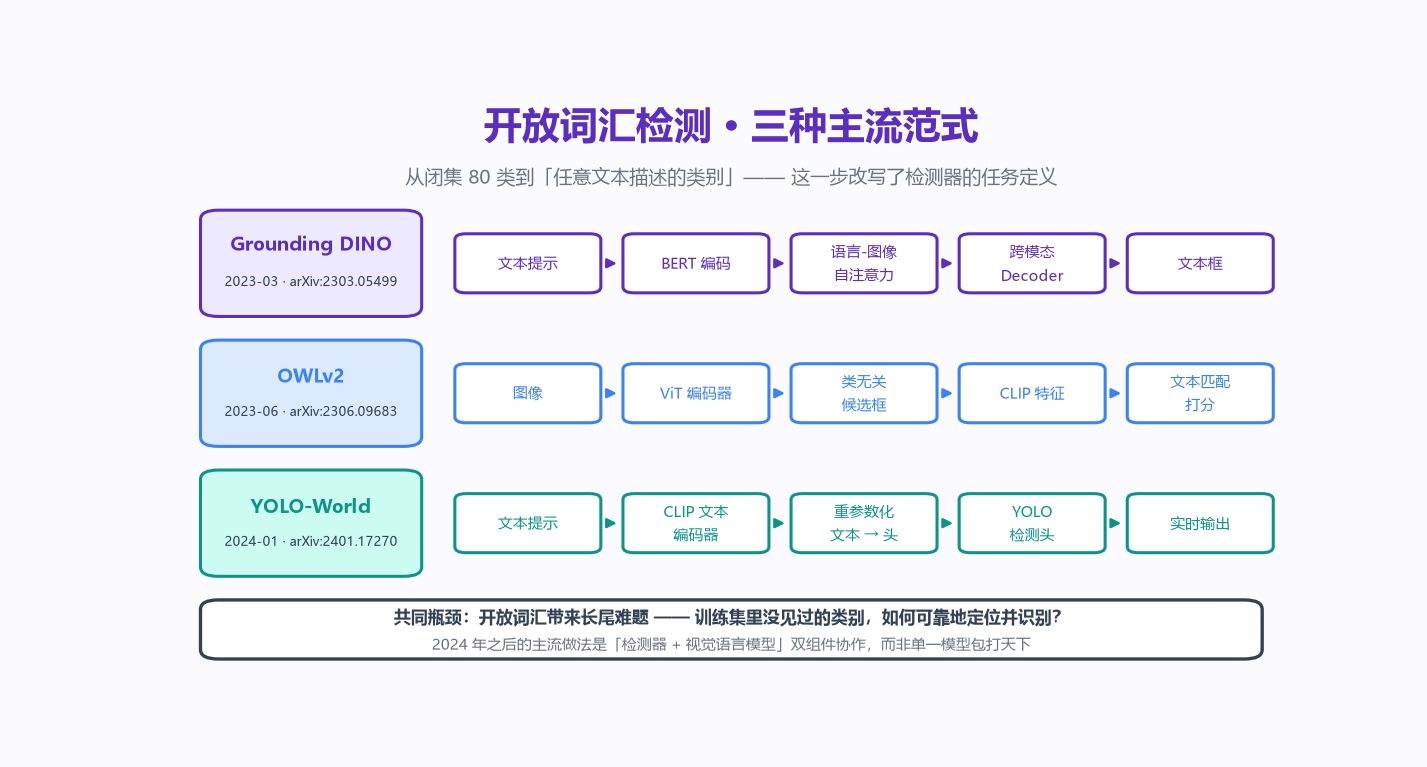
开放词汇检测改变了任务定义本身:类别不再由训练集给定,而是由一句文本提示给出。技术路线分成两派——先检测再分类(OWLv2、DetRefiner、ExDet)与深度跨模态融合(Grounding DINO、FlowOVD)。2026 年的新趋势是二者融合,并普遍采用「检测器 + 视觉语言模型」的双组件协作。
14:开放词汇检测三种主流范式:Grounding DINO / OWLv2 / YOLO-World
图 14 · 开放词汇检测三种主流范式:Grounding DINO / OWLv2 / YOLO-World
ECCV 2024 开放词汇检测 奠基前置

Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection

Grounding DINO:把 DINO 与接地预训练结合用于开放集检测
arXiv:2303.05499 · 2023-03-09 · Shilong Liu、Zhaoyang Zeng、Tianhe Ren 等 12 人
核心思想在 DETR 的图像分支与文本分支之间加入跨模态自注意力,让文本与图像特征在 Encoder 阶段就充分交互,模型因此理解的是「文本框」而不只是类别名。
创新点
  • 图像—文本跨模态自注意力,取代早期「先检测再分类」的后融合
  • 逐阶段文本—图像特征融合 + 语言引导的框查询选择
  • 引入大规模接地预训练数据,大幅提升开放集泛化
  • 输出与文本对齐的框,可直接交给 SAM 等下游模型
📊 COCO 51.3 AP;ODinW-35 / LVIS 零样本约 35 AP 量级
✍️ 开放词汇检测的必引工作;写「检测器 + 视觉语言模型协同」范式时的起点。
arXiv:2303.05499 原文 ↗
ECCV 2024 开放词汇检测 奠基前置

Scaling Open-Vocabulary Object Detection

扩展开放词汇目标检测的规模(OWLv2)
arXiv:2306.09683 · 2023-06-16 · Matthias Minderer、Alexey Gritsenko、Neil Houlsby
核心思想把开放词汇检测拆成「类无关候选框 + 文本对齐分类」两步,并用大规模图文预训练与自训练蒸馏,把 OWL 从 ViT-B/32 扩展到 ViT-H/14 规模。
创新点
  • 类无关候选框 + CLIP 式文本匹配的解耦架构
  • 37 亿图文对的大规模图文预训练,提升细粒度对齐
  • 自训练 + 蒸馏挖掘伪标签,弥补开放词汇标注稀缺
  • 规模化收益的系统性验证(更大骨干 + 更高分辨率)
📊 LVIS 零样本 17.1 AP(ViT-H/14),较 OWL v1 提升约 9 AP
✍️ 与 Grounding DINO 并列的两大开放词汇路线(先分类 vs 深度融合)之一,写对比时通常成对引用。
arXiv:2306.09683 原文 ↗
CVPR 2024 开放词汇检测 近三年窗口内

YOLO-World: Real-Time Open-Vocabulary Object Detection

YOLO-World:实时开放词汇目标检测
arXiv:2401.17270 · 2024-01-30 · Tianheng Cheng、Lin Song、Yixiao Ge 等 6 人
核心思想在 YOLO 的文本—图像骨干上做重参数化,把离线训练好的文本嵌入「蒸馏」进一个图像嵌入分支,推理时只需文本嵌入 + 图像嵌入即可检测任意文本类别,同时保住 YOLO 的速度。
创新点
  • 文本—图像骨干重参数化:训练用文本分支,推理用图像分支
  • 文本嵌入预训练 + 对比预训练增强文本—图像对齐
  • 以 CLIP 图像嵌入作为「语言引导」,桥接任意文本输入
  • 保持 YOLO 级实时速度,可直接输出开放词汇检测结果
📊 COCO 约 55 AP 量级;多提示词 mAP 与单提示词接近
✍️ 开放词汇与实时之间的折中方案;写「实时开放词汇」或与 Grounding DINO 做速度对比时引用。
arXiv:2401.17270 原文 ↗
arXiv 2026-05 开放词汇检测 近三年窗口内

The Detector Teaches Itself: Lightweight Self-Supervised Adaptation for Open-Vocabulary Object Detection

The Detector Teaches Itself:面向开放词汇检测的轻量自监督适配
arXiv:2605.03642 · 2026-05-05 · Yazhe Wan、Changjae Oh
核心思想协作范式中 VLM 是在整图上预训练的,难以捕捉局部目标细节,限制了它在区域级检测中的作用;DAT 用闭集检测器构造「区域感知伪标注」数据集,来自监督地微调 VLM 的视觉骨干。
创新点
  • 区域感知伪标注:新类别区域可能未标注或被误标,但仍参与训练
  • 解耦式微调 + 权重插值:增强局部对齐的同时保留全局语义
  • 即插即用、零推理开销,微调参数不到 0.8M
📊 在 COCO 与 LVIS 上稳定提升协作式开放词汇检测效果
✍️ 讨论「VLM 特征不适合区域级任务」或「检测器与 VLM 互相教学」时引用;思路轻巧,适合做课程里的复现实验。
arXiv:2605.03642 原文 ↗
arXiv 2026-05 开放词汇检测 近三年窗口内

DetRefiner: Model-Agnostic Detection Refinement with Feature Fusion Transformer

DetRefiner:基于特征融合 Transformer 的模型无关检测精修
arXiv:2605.10190 · 2026-05-11 · Soichiro Okazaki、Tatsuya Sasaki、Hiroki Ohashi
核心思想开放词汇检测受限于全局与局部上下文线索融合不足,DetRefiner 提出即插即用的精修框架:把基础模型(DINOv3 等)的全局图像特征与 patch 级特征送进轻量 Transformer 编码器,产出一个类别向量与一组 patch 向量,据此推断属性可靠性并重标定基础检测器的置信度。
创新点
  • 全局 / 局部特征融合 Transformer,同时输出类别向量与 patch 向量
  • 属性可靠性推断:据此重标定基础检测器的置信度分数
  • 与基础 OVOD 模型解耦训练——既不需要访问其内部特征,也不需要重训
  • 推理时只消费基础检测器的预测结果,不侵入主干结构
📊 在 COCO / LVIS / ODinW13 / Pascal VOC 上对多个 OVOD 模型一致提升,新类别最多 +10.1 AP
✍️ 写「后处理式精修」「置信度校准」或「检测器 + 基础模型协作」时引用;是 2026 年开放词汇方向易复现的改进。
arXiv:2605.10190 原文 ↗
arXiv 2026-05 开放词汇检测 近三年窗口内

FlowOVD: Learning Generative Latent Flows for Zero-shot Open-vocabulary Detection

FlowOVD:用生成式潜流做零样本开放词汇检测
arXiv:2606.00782 · 2026-05-30 · Yao Wei、Andrea Cavallaro、Changjae Oh
核心思想现有开放词汇检测把 decoder query 当成静态的或仅由编码器特征初始化,限制了查询的多样性与灵活性;FlowOVD 改用生成式视角,把 query 生成建模为潜空间中的连续传输过程。
创新点
  • 用 rectified flow 把「文本无关 query」连续地搬运成「文本引导 query」
  • 文本条件的生成式查询生成,取代启发式离散 query 构造
  • 连续潜空间动力学带来更有表达力的语义对齐
  • 无需任何额外训练数据
📊 COCO 49.5 AP、LVIS 31.5 AP;较 Grounding DINO 分别 +1.2 AP 与 +4.1 AP
✍️ 写「生成式 / 扩散式检测」或「query 初始化机制」时引用;与 DiffusionDet 是同一支思路的现代版。
arXiv:2606.00782 原文 ↗
arXiv 2026-06 开放词汇检测 近三年窗口内

ExDet: Open-Domain Open-Vocabulary Detection with Cross-modal Extrapolation and Rectification

ExDet:带跨模态外推与校正的开放域开放词汇检测
arXiv:2606.09360 · 2026-06-08 · Yupeng Zhang、Yuzhong Feng、Ruize Han 等 6 人
核心思想开放域开放词汇检测(ODOVD)要求同时泛化到新类别与新域,而现有做法把开放词汇检测器与域泛化模块一起从头训练、成本高昂;ExDet 提出轻量的「类别—域协同泛化」框架,即插即用地增强已有检测器。
创新点
  • TGE 文本引导外推:利用视觉语言模型的 DeltaSpace 性质,从文本推出类别 / 域感知的代理视觉原型
  • DCR 检测器兼容校正:以免训练、免真实数据的方式学习,把表示校正回检测器友好的源域分布
  • ExRPN:结合语义相似度与 RPN 置信度重标定候选框分数,提升新类别召回
📊 在开放域 OVD 基准上同时提升新类别与新域的泛化能力(详见原文)
✍️ 写「域泛化 + 开放词汇」或「免训练校正」时引用;是开放域这一子方向的代表工作。
arXiv:2606.09360 原文 ↗
arXiv 2026-08 开放词汇检测 近三年窗口内

OPUS: A Simple yet Effective Unified Framework for Open-Vocabulary Detection

OPUS:一个简洁而有效的统一开放词汇检测框架
arXiv:2608.30247 · 2026-08-31 · Xiaoyan Wei、Zhimin Yao、Ruilin Yang 等 7 人
核心思想反思统一开放词汇检测是否真的需要繁重的跨模态融合、分阶段训练与迭代式标注管线;结论是——在基础模型更强的今天,靠语义丰富的视觉表示 + 可扩展的接地监督就能把统一 OVD 做得很简单。
创新点
  • 三段式极简架构:语义视觉编码器 + 高效混合编码 + 提示感知解码器
  • 统一支持文本 / 交互视觉 / 通用视觉 / 混合四类提示,且不设提示专用分支
  • 一阶段文本-视觉训练策略 + 实例级对比对齐(ICA)
  • 基于 SAM3 的单遍数据引擎,自动生成异质接地监督
📊 在 COCO、LVIS-minival、ODinW35 等基准上验证(详见原文)
✍️ 讨论「开放词汇检测要不要做得很复杂」时引用;是一篇方法论意义上很有分量的「做减法」论文。
arXiv:2608.30247 原文 ↗
arXiv 2026-10 开放词汇检测 近三年窗口内

FocusOVD: Geometric and Contextual Feature Refinement for Open-Vocabulary Small-Object Detection

FocusOVD:面向开放词汇小目标检测的几何与上下文特征精修
arXiv:2610.27479 · 2026-10-20 · Hanlin Kou、Beiqi Bai、Li Chen 等 6 人
核心思想开放词汇检测在小目标上受限于高分辨率细节保留不足、跨层特征聚合无效、区域判别力有限三个问题;FocusOVD 在不改动冻结 VLM 骨干的前提下,用三个互补模块增强小目标表征。
创新点
  • 加权跨尺度特征融合:学习归一化的逐层权重,平衡浅层外观细节与深层语义
  • 残差风车形门控卷积:强化高分辨率特征中的局部几何响应
  • 残差卷积门控线性单元:抑制背景主导的激活,提升 RoI 判别力
📊 COCO-OVD 上新类别 AP 达 36.3%,超过 CORA、UniDet 等对比方法
✍️ 把「开放词汇」与「小目标」两条线接起来时引用;这是目前少见的同时覆盖两者的组合。
arXiv:2610.27479 原文 ↗
04

视觉基础模型

一个模型,多种任务
Florence-2 把检测、指代、描述、密集标注统一成文本生成;SAM 2 把提示分割扩展到视频并用记忆机制保持时序一致;DINOv2 / DINOv3 则提供可冻结即用的通用视觉骨干。这一支对检测器的作用通常不是直接替换,而是提供更强的特征与更强的开放词汇先验。
TMLR 2024 视觉基础模型 奠基前置

DINOv2: Learning Robust Visual Features without Supervision

DINOv2:无监督学习鲁棒视觉特征
arXiv:2304.07193 · 2023-04-14 · Maxime Oquab、Timothée Darcet、Théo Moutakanni 等 26 人
核心思想用自蒸馏配合自监督掩码策略,让学生在无标签数据上学会与教师一致的表征,把自监督预训练从「为分类服务」推进到「提供通用视觉特征」。
创新点
  • 自蒸馏 + 自监督掩码的组合,规避跨样本蒸馏的不稳定
  • 特征自举(居中 + 锐化)防止表示坍塌
  • 海量无标签数据 + 多套预训练策略,特征可直接线性探测
📊 冻结骨干在 COCO 检测上带来可观提升;线性探测优于同期有监督模型
✍️ 讨论「骨干网络怎么选」「自监督预训练值不值」时引用;也是 DETR 系列最常换的骨干来源。
arXiv:2304.07193 原文 ↗
CVPR 2024 视觉基础模型 奠基前置

Florence-2: Advancing a Unified Representation for a Variety of Vision Tasks

Florence-2:用统一表示处理多种视觉任务
arXiv:2311.06242 · 2023-11-10 · Bin Xiao、Haiping Wu、Weijian Xu 等 9 人
核心思想用一个序列到序列模型统一指代表达、检测、描述、密集标注四类任务,把不同任务都变成「统一 prompt token 输入 + 文本生成输出」。
创新点
  • 统一的 prompt-token 输入接口与序列生成输出
  • 多任务混合训练,任务之间互相增益
  • 构建 FLD-5B 大规模数据集(54 亿自动标注样本)
  • 单模型零样本即可完成开放词汇检测与分割
📊 COCO 零样本检测 56.8 AP;指代分割任务大幅领先同期模型
✍️ 讲「视觉基础模型统一多任务」时引用;是「检测器 + 基础模型」双组件范式里关键的一环。
arXiv:2311.06242 原文 ↗
ICLR 2025 视觉基础模型 近三年窗口内

SAM 2: Segment Anything in Images and Videos

SAM 2:对图像和视频做万物分割
arXiv:2408.00714 · 2024-08-01 · Nikhila Ravi、Valentin Gabeur、Yuan-Ting Hu 等 18 人
核心思想把 SAM 的分割架构扩展到视频——提出流式记忆机制,按帧增量地把上一帧的分割结果编码进记忆库,使模型能在视频上同时处理物体提示与点击提示并保持时序一致。
创新点
  • 流式记忆机制 + 记忆银行 + 记忆注意力
  • 统一图像与视频的提示分割接口
  • 面向提示的时序一致性训练数据生成管线
  • 开放世界的可提示视频对象分割
📊 视频分割基准上大幅超越此前方法;SA-V 分割表现尤为突出
✍️ 讨论「检测 + 分割协同」或「视觉基础模型的时序扩展」时引用;是与检测器天然互补的一环。
arXiv:2408.00714 原文 ↗
arXiv 2025 视觉基础模型 近三年窗口内

DINOv3

DINOv3:面向工业级视觉任务的第二代自监督基础模型
arXiv:2508.10104 · 2025-08-13 · Oriane Siméoni、Huy V. Vo、Maximilian Seitzer 等 26 人
核心思想把自监督视觉预训练扩展到超大规模无标签互联网图像与 7B 参数级模型,产出兼具高层语义与稠密空间信息的通用视觉骨干,并用 Gram 锚定与高分辨率适配支撑像素级任务。
创新点
  • 超大规模自监督训练(7B 参数级)与海量无标签数据
  • Gram 锚定:用自相似矩阵稳定稠密特征
  • 高分辨率适配:高分辨率推理与位置编码插值
  • 冻结骨干即可在检测 / 分割上带来大幅提升
📊 冻结骨干在 COCO / LVIS 分割检测上显著超过此前自监督模型
✍️ 讨论「自监督基础模型的最新进展」或「冻结骨干 vs 全量微调」时引用。
arXiv:2508.10104 原文 ↗
05

骨干网络

特征质量决定上限
TransNeXt 用聚合邻域注意力刻画注视点聚集特性,VMamba 用状态空间模型以线性复杂度换取全局感受野,VGTok 则把「固定 token 网格」改成「按区域变粒度」。骨干侧的变化常常比检测头更直接地影响小目标与密集目标的表现,也是课程实验里最容易做出可复现消融的一环。
CVPR 2024 骨干网络 奠基前置

TransNeXt: Robust Foveal Visual Perception for Vision Transformers

TransNeXt:鲁棒的注视点式视觉感知 Transformer
arXiv:2311.17132 · 2023-11-28 · Dai Shi
核心思想提出聚合邻域注意力——在局部窗口内把 query 与其邻近 key/value 一并聚合,用连续位置偏置与可学习半径刻画人类注视点的聚集特性,兼顾线性复杂度与密集目标表现。
创新点
  • 聚合邻域注意力(Aggregated Neighborhood Attention)
  • 连续位置偏置建模跨窗口的相对位置关系
  • 可学习聚合半径,自适应分配注意力范围
  • 分类 / 检测 / 分割三任务通用骨干
📊 COCO 检测 AP 51.8 量级,同参数量下优于 ConvNeXt 与 Swin
✍️ 讨论「注意力骨干 vs 卷积骨干」时的近期代表;也适合作为「换骨干做消融」的实验素材。
arXiv:2311.17132 原文 ↗
NeurIPS 2024 (Spotlight) 骨干网络 近三年窗口内

VMamba: Visual State Space Model

VMamba:视觉状态空间模型
arXiv:2401.10166 · 2024-01-18 · Yue Liu、Yunjie Tian、Yuzhong Zhao 等 9 人
核心思想把状态空间模型(SSM)引入视觉骨干,用选择性扫描沿四个方向在图像上做线性复杂度建模,以卷积级别的速度获得全局感受野,替代自注意力的平方复杂度。
创新点
  • 视觉 SSM 骨干 + 跨方向扫描的二维状态空间建模
  • 选择性扫描机制,按输入内容自适应决定保留或丢弃信息
  • 与 CNN 同为线性复杂度,可扩展到高分辨率输入
  • VSSM 系列即插即用,可直接替换 DETR / YOLO 的骨干
📊 吞吐与卷积相当;检测 / 分割上优于同规模 ViT 与 Swin
✍️ 谈小目标、高分辨率任务的骨干选择,或介绍 SSM 视觉化时引用;「视觉 Mamba」这一支的代表作。
arXiv:2401.10166 原文 ↗
arXiv 2026-08 骨干网络 近三年窗口内

Variable-Granularity Tokenization for High-Resolution Object Detection

VGTok:面向高分辨率目标检测的可变粒度 Tokenization
arXiv:2608.28706 · 2026-08-27 · Khayrul Islam
核心思想ViT 检测器在进入任何学习模块之前就固定了统一的 token 网格,原生分辨率的航拍检测器只能在「解析几像素目标」与「守住算力显存上限」之间二选一;VGTok 是一个免训练 tokenizer,在编码之前按区域从像素出发设定 patch 粒度。
创新点
  • 以多尺度形态学 top-hat 可分性为每个区域打分,按每图像分位数阈值锁定 token 预算
  • 结构张量门控(λ_min):只在二维目标结构成立处细化,一维杂乱保持粗粒度
  • 产出的 token 集合是图像的严格划分,无重复无遗漏
  • 训练无关,可作为冻结 checkpoint 的即插即用模块
📊 Co-DETR + EVA-02 ViT-L 在 VisDrone-val 上 40% token 预算即达 44.22 AP,密集设定 48.38 AP(较最强已发表结果 +6.08);AI-TOD-v2 达 37.27 AP
✍️ 讨论「高分辨率 / 密集小目标」与「token 预算」时引用;把「分辨率—算力矛盾」换了个问法,值得借鉴。
arXiv:2608.28706 原文 ↗

小目标检测:一个还没被解决干净的矛盾

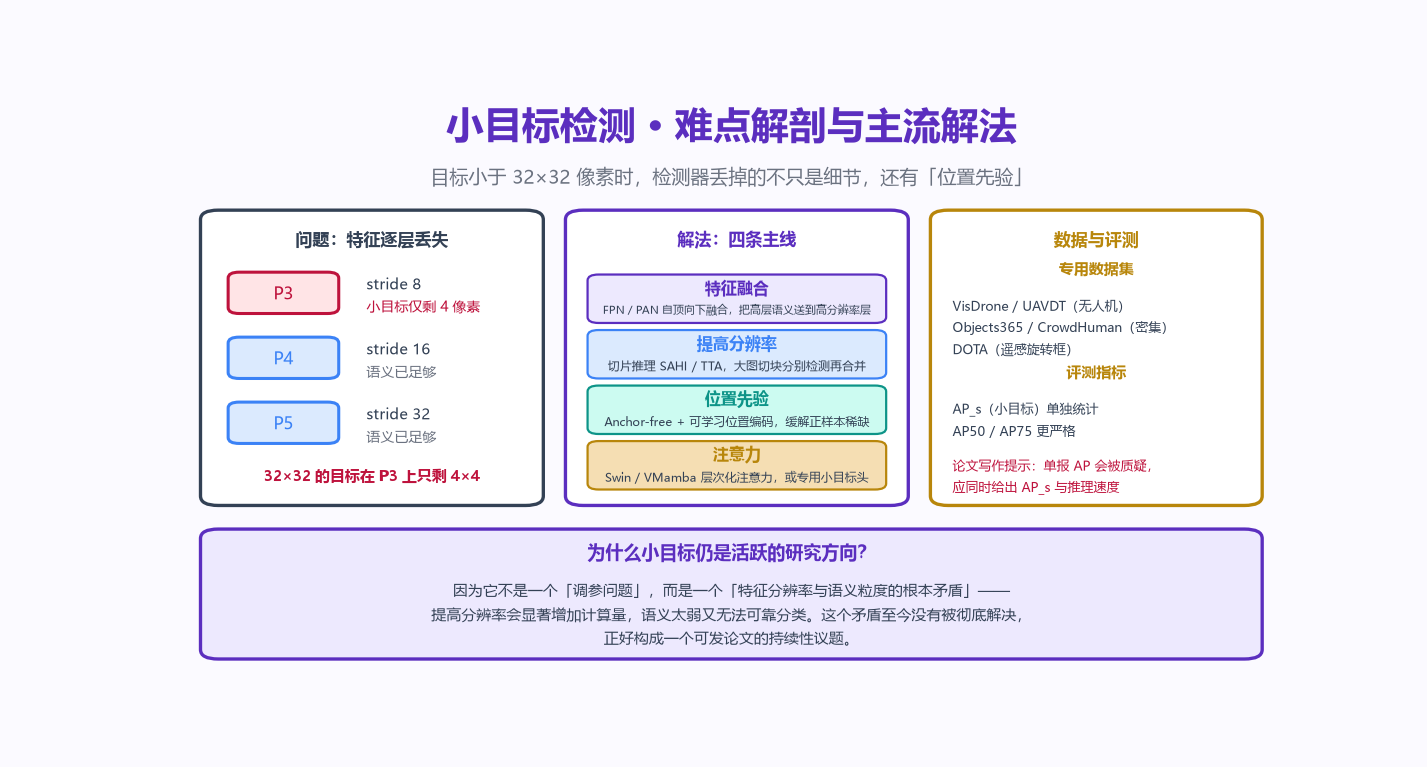
目标小于 32×32 像素时,检测器丢掉的不只是细节,还有「位置先验」。 这是一个适合持续发论文的议题。

小目标检测难点解剖图:左侧展示 P3/P4/P5 三个尺度的特征逐层丢失,32×32 目标在 P3 上只剩 4×4;中间列出特征融合、提高分辨率、位置先验、注意力四条解法主线;右侧列出 VisDrone、Objects365、DOTA 等专用数据集与 AP_s 评测指标
图 15 · 小目标检测难点解剖(点击放大)

🔍 为什么小目标还是热点

它不是一个「调参问题」,而是特征分辨率与语义粒度的根本矛盾:提高分辨率会显著增加计算量,语义太弱又无法可靠分类。这个矛盾至今没有被彻底解决,因此每一年都有新论文。

📐 四条解法主线

特征融合(FPN / PAN 自顶向下)· 提高分辨率(SAHI 切片推理、TTA)· 位置先验(anchor-free + 可学习位置编码)· 注意力(Swin / VMamba 层次化注意力、专用小目标头)。

✍️ 写论文的注意事项

单报 AP 一定会被质疑。必须同时给出 AP_s(小目标)与推理速度,并在 VisDrone / AI-TOD / UAVDT 上验证——否则审稿人会认为你没有真正解决小目标。

近三年目标检测:四条研究主线

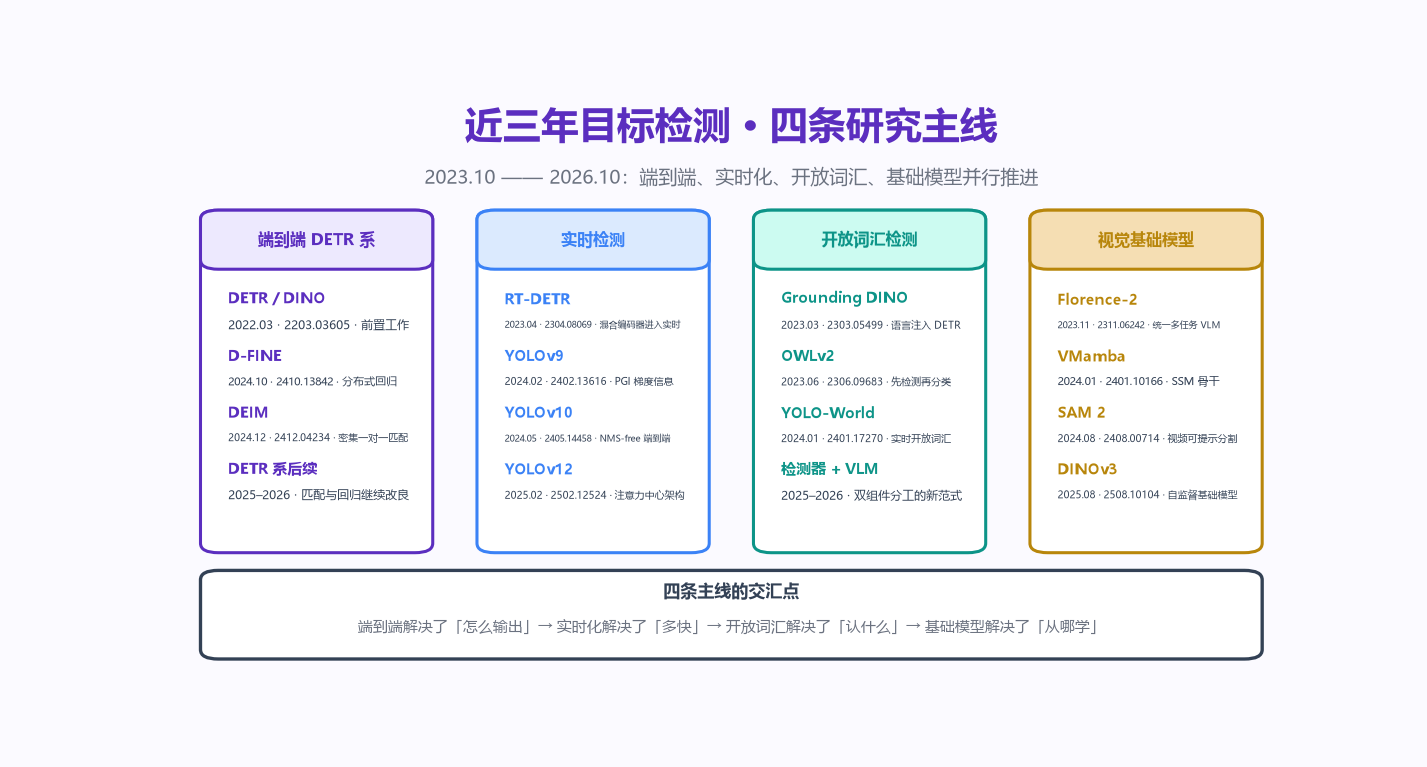
端到端、实时化、开放词汇、基础模型——四条线并行推进,并在 2026 年开始交汇。

近三年目标检测四条研究主线图:端到端 DETR 系、实时检测、开放词汇检测、视觉基础模型四条泳道,每条列出代表工作、arXiv 编号与一句话贡献,底部总结四条主线的交汇点
图 16 · 近三年目标检测四条研究主线(点击放大)

复现实验路线:4 个实验,从零到发论文

这四个实验按顺序做完,学生能独立复现近三年的代表性工作;老师能直接在此基础上派生自己的论文。

LAB 01 · 基础

把检测器拆开看:复现 Faster R-CNN 与 YOLOv8

先用最朴素的两条路线跑通,理解「候选框 → 分类回归」与「密集预测」的差别。

  • COCO val2017 子集,ResNet-50 骨干
  • 记录 AP / AP50 / AP75 / 参数量 / 单图延迟
  • 对比 anchor-based 与 anchor-free 的正负样本分配差异
产出:一张基础性能对照表 + 一份 loss 曲线分析
LAB 02 · 端到端

复现 DINO,并把它训到 12 epoch

理解集合预测、匈牙利匹配与去噪训练这三件事,是 DETR 系所有后续工作的前提。

  • 实现简化的二分图匹配(scipy linear_sum_assignment)
  • 实现 CDN 去噪训练,观察收敛速度的差异
  • 记录 12 / 50 / 300 epoch 各自的 AP 曲线
产出:去噪训练前后的收敛速度对比图(可直接进论文)
LAB 03 · 改进

在 DINO 上叠加 DEIM 与 D-FINE

验证「匹配机制」与「回归形式」两条改进轴可以独立叠加——这是最好讲的一个故事。

  • 把一对一匹配改成 Dense O2O(每个 GT 取 Top-K)
  • 把 L1 回归换成细粒度分布细化(FDR)
  • 做 2×2 消融:DINO / +DEIM / +D-FINE / 两者都加
产出:2×2 消融表,直接支撑「两条线正交」的论点
LAB 04 · 小目标

小目标专项:SAHI 切片 + AP_s 评测

把前面的模型放到无人机小目标场景上,顺带摸清这个方向的真实痛点。

  • 在 VisDrone / AI-TOD-v2 上评测 AP_s 与 AP50
  • 实现 SAHI 切片推理,比较切块尺寸对 AP_s 的影响
  • 分析失败案例:密集遮挡、极小目标、背景干扰
产出:小目标失败模式分析,为选题提供依据

科研选题建议:6 个可直接开题的方向

按「投入产出比」排序。难度标签:🟢 硕士一年级可做 · 🟡 需要一定工程积累 · 🔴 需要算力或新数据。

🟢 难度低

DETR 系的「正样本数量」消融:匹配机制到底在做什么

DEIM 主张密集一对一匹配带来更快的收敛,BUTR(arXiv:2610.33430)则用实验指出 动态查询的主要作用其实是预算分配而非精细选择——这两个结论未必矛盾。 系统地做一组「匹配策略 × query 预算」的二维消融,是一个工作量可控但结论有价值的题目。

数据集:COCO + CrowdHuman(密集场景)· 算力:单卡 A10 即可
🟢 难度低

骨干替换的系统性消融:ConvNet / Swin / SSM / 变粒度 token

把 ConvNeXt、Swin、VMamba、TransNeXt、VGTok 统一接到同一个 DETR 框架下, 在小目标与密集目标上做横向对比。 「特征质量 → 检测性能」的传导路径目前缺少系统结论,是一篇扎实的短文。

数据集:COCO + VisDrone · 算力:单卡 A10 即可
🟡 难度中

开放词汇 × 小目标的交叉空白

FocusOVD(arXiv:2610.27479)只做了 2026 年 10 月这一篇,说明这个交叉方向还很空。 开放词汇方法普遍在 COCO-OVD 上刷分,但很少认真报告 AP_s 与长尾小类别。 补上这一块,并给出「类别新颖度 × 目标尺度」二维评测,是很自然的一个缺口。

数据集:COCO-OVD + LVIS-OVD + VisDrone
🟡 难度中

把扩散 / 流模型用到检测结果分布上

DiffusionDet(ICCV 2023)与 FlowOVD(arXiv:2606.00782)说明「把检测当作生成过程」是可行的, 但这条线近三年明显比 DETR 线冷。值得做的是:在同框架下对比集合预测与扩散去噪, 并回答一个具体问题——生成式范式在密集目标上是不是天然更强?

数据集:COCO + CrowdHuman · 算力:需要 4 卡级别
🟡 难度中

「训练-推理一致性」的统一视角

YOLOv9(梯度信息)、YOLOv10(双重标签分配)、DETRNN(查询排序)本质上都在处理同一件事: 让训练时看到的东西和推理时输出的东西一致。 把这三条路线放进同一个评价框架里(正样本分配的一致性度量), 是一个有观点、且能写成综述的题目。

数据集:COCO · 算力:单卡 A10 即可
🔴 难度高

面向具体行业的开放词汇落地:一份可复用的评测基准

通用 OVD 的论文已经很多,但行业场景下的开放词汇评测几乎空白。 挑一个真实行业(电力巡检、港口、养殖、零售货架),构建带真实长尾类别的开放词汇基准, 并给出基线方法。数据与评测本身就是论文的贡献。

数据集:需自行采集与标注 · 算力:视数据规模而定

可引用文献清单

标题、作者、日期与 arXiv 编号均取自 arXiv 官方 API 原始返回,可直接照抄引用。

arXiv:2610.33430
近三年
Dynamic Query as Budgeting for Tiny Object Detection
Dynamic Query as Budgeting:把小目标检测的动态查询重述为「预算分配」
Yi Zhang、Di Xiong、Ge Gao 等 7 人 · 2026-10-24
arXiv 2026-10
arXiv 原文 ↗
arXiv:2610.27479
近三年
FocusOVD: Geometric and Contextual Feature Refinement for Open-Vocabulary Small-Object Detection
FocusOVD:面向开放词汇小目标检测的几何与上下文特征精修
Hanlin Kou、Beiqi Bai、Li Chen 等 6 人 · 2026-10-20
arXiv 2026-10
arXiv 原文 ↗
arXiv:2610.09502
近三年
RT-DETR-World: Transferring Rich LLM Semantics to Real-Time Open-Vocabulary Detection
RT-DETR-World:把大语言模型的丰富语义迁移到实时开放词汇检测
Yupeng Zhang、Ziyi Zhao、Juntao Cheng 等 7 人 · 2026-10-07
arXiv 2026-10
arXiv 原文 ↗
arXiv:2610.05191
近三年
Order Matters: Competition-Guided Query Ordering for RNN-Based Object Detection
Order Matters:面向 RNN 式目标检测的竞争引导查询排序
Shengjian Wu、Li Sun、Yu Shangguan 等 4 人 · 2026-10-04
arXiv 2026-10
arXiv 原文 ↗
arXiv:2608.30247
近三年
OPUS: A Simple yet Effective Unified Framework for Open-Vocabulary Detection
OPUS:一个简洁而有效的统一开放词汇检测框架
Xiaoyan Wei、Zhimin Yao、Ruilin Yang 等 7 人 · 2026-08-31
arXiv 2026-08
arXiv 原文 ↗
arXiv:2608.28706
近三年
Variable-Granularity Tokenization for High-Resolution Object Detection
VGTok:面向高分辨率目标检测的可变粒度 Tokenization
Khayrul Islam · 2026-08-27
arXiv 2026-08
arXiv 原文 ↗
arXiv:2609.26092
近三年
Match One, Learn with Graph: One-to-Graph Query Collaboration with Backward Sharing for Object Detection
Match One, Learn with Graph:面向目标检测的一对一图查询协作与反向共享
Wenxiao Fan、Jingling Fu、Luohang Liu 等 11 人 · 2026-08-06
arXiv 2026-08
arXiv 原文 ↗
arXiv:2606.09360
近三年
ExDet: Open-Domain Open-Vocabulary Detection with Cross-modal Extrapolation and Rectification
ExDet:带跨模态外推与校正的开放域开放词汇检测
Yupeng Zhang、Yuzhong Feng、Ruize Han 等 6 人 · 2026-06-08
arXiv 2026-06
arXiv 原文 ↗
arXiv:2606.00782
近三年
FlowOVD: Learning Generative Latent Flows for Zero-shot Open-vocabulary Detection
FlowOVD:用生成式潜流做零样本开放词汇检测
Yao Wei、Andrea Cavallaro、Changjae Oh · 2026-05-30
arXiv 2026-05
arXiv 原文 ↗
arXiv:2605.10190
近三年
DetRefiner: Model-Agnostic Detection Refinement with Feature Fusion Transformer
DetRefiner:基于特征融合 Transformer 的模型无关检测精修
Soichiro Okazaki、Tatsuya Sasaki、Hiroki Ohashi · 2026-05-11
arXiv 2026-05
arXiv 原文 ↗
arXiv:2605.03642
近三年
The Detector Teaches Itself: Lightweight Self-Supervised Adaptation for Open-Vocabulary Object Detection
The Detector Teaches Itself:面向开放词汇检测的轻量自监督适配
Yazhe Wan、Changjae Oh · 2026-05-05
arXiv 2026-05
arXiv 原文 ↗
arXiv:2603.07022
近三年
OV-DEIM: Real-time DETR-Style Open-Vocabulary Object Detection with GridSynthetic Augmentation
OV-DEIM:带网格合成增广的实时 DETR 式开放词汇目标检测
Leilei Wang、Longfei Liu、Xi Shen 等 7 人 · 2026-03-07
arXiv 2026-03
arXiv 原文 ↗
arXiv:2508.10104
近三年
DINOv3
DINOv3:面向工业级视觉任务的第二代自监督基础模型
Oriane Siméoni、Huy V. Vo、Maximilian Seitzer 等 26 人 · 2025-08-13
arXiv:2502.12524
近三年
YOLOv12: Attention-Centric Real-Time Object Detectors
YOLOv12:以注意力为中心的实时目标检测器
Yunjie Tian、Qixiang Ye、David Doermann · 2025-02-18
arXiv:2412.04234
近三年
DEIM: DETR with Improved Matching for Fast Convergence
DEIM:用改进的匹配实现快速收敛的 DETR
Shihua Huang、Zhichao Lu、Xiaodong Cun 等 6 人 · 2024-12-05
arXiv:2410.13842
近三年
D-FINE: Redefine Regression Task in DETRs as Fine-grained Distribution Refinement
D-FINE:把 DETR 的回归任务重新定义为细粒度分布细化
Yansong Peng、Hebei Li、Peixi Wu 等 6 人 · 2024-10-17
arXiv:2408.00714
近三年
SAM 2: Segment Anything in Images and Videos
SAM 2:对图像和视频做万物分割
Nikhila Ravi、Valentin Gabeur、Yuan-Ting Hu 等 18 人 · 2024-08-01
arXiv:2405.14458
近三年
YOLOv10: Real-Time End-to-End Object Detection
YOLOv10:实时端到端目标检测
Ao Wang、Hui Chen、Lihao Liu 等 7 人 · 2024-05-23
NeurIPS 2024
arXiv 原文 ↗
arXiv:2402.13616
近三年
YOLOv9: Learning What You Want to Learn Using Programmable Gradient Information
YOLOv9:用可编程梯度信息学习你想学的东西
Chien-Yao Wang、I-Hau Yeh、Hong-Yuan Mark Liao · 2024-02-21
arXiv:2401.17270
近三年
YOLO-World: Real-Time Open-Vocabulary Object Detection
YOLO-World:实时开放词汇目标检测
Tianheng Cheng、Lin Song、Yixiao Ge 等 6 人 · 2024-01-30
arXiv:2401.10166
近三年
VMamba: Visual State Space Model
VMamba:视觉状态空间模型
Yue Liu、Yunjie Tian、Yuzhong Zhao 等 9 人 · 2024-01-18
NeurIPS 2024 (Spotlight)
arXiv 原文 ↗
arXiv:2311.17132
奠基
TransNeXt: Robust Foveal Visual Perception for Vision Transformers
TransNeXt:鲁棒的注视点式视觉感知 Transformer
Dai Shi · 2023-11-28
arXiv:2311.06242
奠基
Florence-2: Advancing a Unified Representation for a Variety of Vision Tasks
Florence-2:用统一表示处理多种视觉任务
Bin Xiao、Haiping Wu、Weijian Xu 等 9 人 · 2023-11-10
arXiv:2306.09683
奠基
Scaling Open-Vocabulary Object Detection
扩展开放词汇目标检测的规模(OWLv2)
Matthias Minderer、Alexey Gritsenko、Neil Houlsby · 2023-06-16
arXiv:2304.08069
奠基
DETRs Beat YOLOs on Real-time Object Detection
DETRs 在实时目标检测上击败 YOLO(RT-DETR)
Yian Zhao、Wenyu Lv、Shangliang Xu 等 8 人 · 2023-04-17
arXiv:2304.07193
奠基
DINOv2: Learning Robust Visual Features without Supervision
DINOv2:无监督学习鲁棒视觉特征
Maxime Oquab、Timothée Darcet、Théo Moutakanni 等 26 人 · 2023-04-14
arXiv:2303.05499
奠基
Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection
Grounding DINO:把 DINO 与接地预训练结合用于开放集检测
Shilong Liu、Zhaoyang Zeng、Tianhe Ren 等 12 人 · 2023-03-09
arXiv:2211.12860
奠基
DETRs with Collaborative Hybrid Assignments Training
协同混合分配训练的 DETR(Co-DETR)
Zhuofan Zong、Guanglu Song、Yu Liu · 2022-11-22
arXiv:2211.09788
奠基
DiffusionDet: Diffusion Model for Object Detection
DiffusionDet:用扩散模型做目标检测
Shoufa Chen、Peize Sun、Yibing Song 等 4 人 · 2022-11-17
ICCV 2023 (Oral)
arXiv 原文 ↗
arXiv:2203.03605
奠基
DINO: DETR with Improved DeNoising Anchor Boxes for End-to-End Object Detection
DINO:带改进去噪锚框的端到端目标检测 DETR
Hao Zhang、Feng Li、Shilong Liu 等 8 人 · 2022-03-07
引用格式示例:Zhang H., Li F., Liu S., et al. DINO: DETR with Improved DeNoising Anchor Boxes for End-to-End Object Detection. ICLR 2023. arXiv:2203.03605.
机器可读的完整元数据(含作者全列表、摘要、更新时间)见仓库中的 data/object-detection-papers.json。

想把这套内容讲成一门课?

目标检测专题可作为 SKC5053 深度学习课程的扩展模块, 或 FDE 培训的进阶实战环节——每个实验都有可运行的代码与评测脚本。

🧠 深度学习课程 SKC5053 📚 查看完整课程大纲 📅 预约演示
¥99 / 年起
标准会员 · 7 天无理由退款
开通会员 预约演示